


Архитектура data-centric: De Novo перестроила логику своей работы
2026-10-21

De Novo перестроила логику работы. Главным объектом защиты становятся клиентские данные, а не инфраструктура операторского ЦОД. Именно такой принцип компания закладывает в новый подход к развитию облака, реализованный с учетом военных угроз.
ЦОД уровня Tier III обеспечивает резервирование ключевых инженерных компонентов и путей их распределения, позволяя обслуживать их без остановки ИТ-систем. Но что произойдет, если «точкой отказа» станет весь дата-центр? Речь идет не только об Украине. Угроза диверсий и внезапных атак уже актуальна для любой страны. Гарантировать клиентам непрерывность бизнес-процессов и быстрое восстановление после катастроф позволяет архитектура data-centric, которая к тому же полностью соответствует новейшим нормативным требованиям.
В статье рассматриваем:
- в чем заключается разница между подходами data-centric и infrastructure resilience;
- какие облачные сервисы обеспечивают настоящую отказоустойчивость;
- как новое украинское законодательство обязывает государственный сектор менять подход к защите данных и как это пересекается с новым подходом De Novo.
Безопасных мест в мире не осталось
Взглянем на факты: война в Украине продолжается уже много лет, однако первыми в истории дата-центрами, попавшими под авиаудары, неожиданно стали объекты гиперскейлеров в, казалось бы, благополучном регионе. Напомним, что в марте 2026 года в результате ударов беспилотников были серьезно повреждены сразу три ЦОД AWS — два в ОАЭ и один в Бахрейне. Клиенты в соответствующем регионе мгновенно ощутили последствия атаки, причем полностью устранить их не удалось даже спустя полгода: например, 15 сентября сообщалось, что оператор все еще не смог восстановить полный доступ к поврежденным объектам.
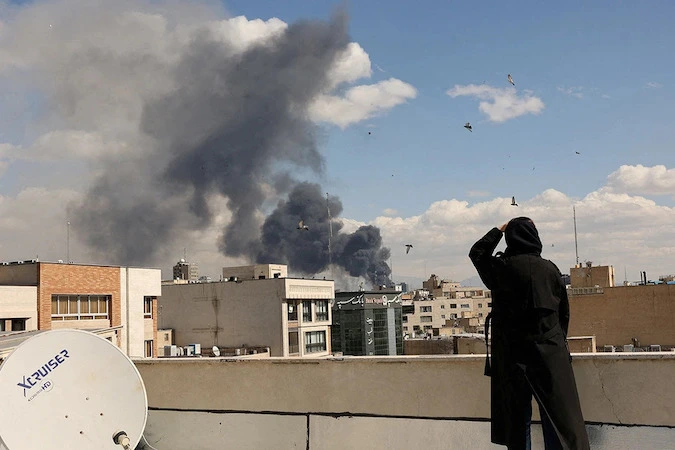
Таким образом, риск, который еще недавно воспринимался как сугубо «украинский», фактически становится частью глобального подхода к построению цифровой инфраструктуры.
«Любой провайдер выглядит молодцом, пока дело не доходит до настоящего стресс-теста. Дата-центры AWS рухнули под ударами, как рухнул бы любой другой дата-центр в мире. Эта ситуация высветила слом привычного мира. Западные мега-ЦОД на 100–200 МВт строились с учетом экономики и масштабирования. Никто никогда не думал, что может быть война. А теперь оказалось, что такой дата-центр можно разрушить одним дроном. Как ту хрустальную пирамиду — она упадет от одного прикосновения.
Поэтому сейчас вопрос должен ставиться иначе: какую концепцию безопасности вы предлагаете? Если мы говорим о подходе Data Center-centric, то все зависит от физического здания. Если мы убираем слово «центр» и говорим Data-centric, то в основе стоят сами данные. Если у вас есть распределенная архитектура и механизмы быстрого восстановления, можно разрушить один или два дата-центра, а система продолжит работать», — отмечал в одном из интервью Максим Агеев, CEO компании De Novo.
Фокус смещается с инфраструктуры на данные
В таких экстремальных условиях традиционный подход infrastructure resilience, смысл которого — не допустить отказа оборудования или площадки, уступает место data resiliency, при котором главным объектом защиты становятся данные клиента. В более широком смысле такой подход можно назвать data-centric architecture: именно данные рассматриваются как центральный актив, а локальная инфраструктура, приложения и процессы выстраиваются вокруг требований к ним.
Главное отличие от классического подхода — в объекте защиты.
- Infrastructure resilience отвечает на вопрос, как не допустить отказа оборудования или площадки.
- Data-centric — что произойдет с данными, если такой отказ все же случится.
«De Novo называет такой подход data-centric: в центре архитектуры должны быть не сервер или площадка, а данные клиента. Для этого создают три-четыре копии данных, используют системы резервирования и географическое разнесение. Например, De Novo использует четыре площадки — две в Украине и две в Европе. Информационные системы могут быть распределены между разными площадками, чтобы обеспечить их восстановление после возможной катастрофы.
Этот подход — альтернатива логике постоянного бегства от риска. Часть данных уже была вынесена за пределы страны, но для систем, которые остаются в Украине, должны действовать новые правила устойчивости — резервирование, дублирование и географическое разнесение. Именно это и есть resilience — способность системы пережить удар, не потеряв главного: данных. Другими словами, неважно, что будет с нашим дата-центром. Важно, что будет с вашими данными. Следовательно, защищать нужно данные, а не дата-центр», — рассказывает Максим Агеев.
При этом надежность отдельного ЦОД по-прежнему обязательна, но она не должна быть единственным условием сохранности данных. На практике наивысший уровень защиты сегодня достигается тогда, когда данные существуют в нескольких независимых формах и местах: на разных системах хранения, в резервных копиях, на географически разнесенных площадках или даже в разных странах и облаках различных операторов.
Ваши данные должны пережить даже полное физическое уничтожение одного или нескольких дата-центров
Для этого сегодня сформировалась общепринятая мировая практика, которой придерживаются как мировые лидеры — гиперскейлеры, так и крупные национальные операторы большинства развитых стран. Ее суть заключается в создании территориально распределенных и физически независимых площадок, объединенных в единую систему. При таком подходе полное уничтожение одного или даже нескольких физических ЦОД не приведет к остановке всей системы.
Но есть один чрезвычайно важный нюанс: сохранность данных не обеспечивается автоматически лишь благодаря размещению в защищенном и распределенном облаке. Создание резервных копий (backup), катастрофоустойчивых решений (Disaster Recovery), управление данными и другие операции остаются ответственностью клиента. Оператор предоставляет инфраструктуру и инструменты для выполнения таких задач.
Максим Агеев подчеркивает: «Ни один провайдер в мире не способен гарантировать непрерывность работы сервисов или доступность данных, если сама архитектура ИТ-системы заказчика не предусматривает резервирования и катастрофоустойчивости. Именно поэтому стоит четко осознавать зону ответственности самого бизнеса».
Государство требует конкретных мер: постановление Кабинета Министров Украины № 1009
Архитектура data-centric приобретает особое значение в контексте последних законодательных изменений в Украине. До недавнего времени требования к защите данных в облаках не всегда были достаточно детализированными, а конкретные решения часто оставались в сфере ответственности каждой организации. Но ситуация меняется. Например, в августе 2026 года было принято постановление Кабинета Министров Украины № 1009 «Некоторые вопросы обеспечения непрерывности функционирования государственных информационных ресурсов», которое достаточно четко описывает требования к защищенной архитектуре хранения важных данных. Стоит отметить, что в документе все ключевые процессы описаны общепринятым языком ИТ, с понятными аббревиатурами, формулировками и конкретными цифрами.
Документ предусматривает три категории информационных систем в зависимости от последствий их остановки, для каждой из которых устанавливаются собственные параметры RTO/RPO.
- cистемы I категории должны обеспечивать RTO не более 8 часов, а RPO — 4 часа;
- для II категории эти показатели составляют 24/12 часов;
- для III — 72/24 часа.
Дополнительно определяется MTPD — максимально допустимое время нарушения работы системы, после которого последствия становятся неприемлемыми (при этом MTPD должно быть больше RTO и не может превышать 1,5 предельного значения RTO соответствующей категории).
Что особенно важно — речь идет не только о защите данных, но и о восстановлении работоспособности всей ИТ-системы, включая ПО, настройки, взаимосвязи и т. д. Фактически описывается полноценный DR-сценарий. Основная и резервная площадки при этом должны быть независимыми, чтобы снизить риск одновременного уничтожения или компрометации данных. Более того, для систем I и II категорий прямо предусмотрено географическое разнесение основного и резервного дата-центров, а если основная система расположена в Украине, как минимум один экземпляр восстановительного резерва должен размещаться в защищенной среде за рубежом. Кстати, прописано и обратное правило: если основная инфраструктура находится за границей, один экземпляр резерва должен оставаться в Украине.
По словам Максима Агеева: «Постановление № 1009 внедряет лучшие мировые DR-практики в сфере государственного управления критически важными данными и ИТ-инфраструктурами. Документ, по сути, формализует и детализирует подходы, которые на практике подтвердили свою эффективность. Безусловно, это чрезвычайно важный шаг на пути к построению действительно защищенных государственных ИТ-систем, шаг, который, на мой взгляд, стоило сделать еще лет десять назад».
То есть простого бэкапа уже недостаточно, по крайней мере для организаций, на которые распространяется регулирование упомянутого постановления (это прежде всего государственные структуры и информационные ресурсы). Кроме того, согласно новым требованиям, организациям необходимо иметь четкий план аварийного восстановления и регулярно, как минимум раз в полгода, его тестировать. Проверка также должна проводиться после любых существенных изменений в ИТ-системе. Среди сценариев, подлежащих проверке, — восстановление данных из резервной копии, переключение (failover) отдельных компонентов или даже всей системы на резервную площадку.
Архитектура data-centric в облаке De Novo
Компания De Novo давно и последовательно развивает комплексную архитектуру защиты данных для различных сценариев. Для этого используется набор специально отобранных и отработанных технологий и независимых механизмов, формирующих единый комплекс защиты. Разные уровни защиты решают различные задачи — от логического повреждения данных до полной потери основной площадки.
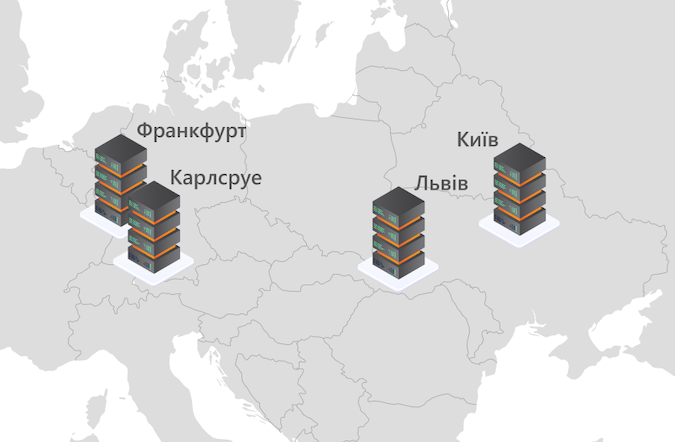
Основу устойчивости инфраструктуры De Novo обеспечивают сразу четыре территориально распределенных дата-центра: по два в Украине (Киев, Львов) и Германии (Франкфурт-на-Майне, Карлсруэ). Что касается механизмов восстановления, то на базовом уровне работают сервисы BaaS и Flex Backup. Они позволяют создавать локальные резервные копии облачной инфраструктуры и хранить их отдельно от основной рабочей среды пользователя. Если требуется защита от потери всей площадки, используется так называемая «геокопия»: сервис BaaS Geo позволяет разместить дополнительную копию данных в другом облаке De Novo на территории Европейского Союза (EU-Cloud), при этом физическое расстояние между облачными площадками составляет не менее 1500 км.
Еще большую независимость обеспечивают BaaS Geo XR и Flex Backup Geo XR. Здесь географическая копия хранится уже в объектном хранилище AWS S3. Заказчику предоставляются отдельные учетные данные для доступа и ключ шифрования, а восстановление возможно в средах VMware и Hyper-V, на платформах AWS, Microsoft Azure и GCP либо обратно в одном из облаков De Novo. Это уже не только защита от потери конкретного ЦОД, но и механизм предотвращения зависимости от одной облачной платформы.
Если основная инфраструктура размещена в собственном дата-центре заказчика, аналогичную задачу выполняет Veeam Cloud Repository (VCR). Пользователи Veeam Backup & Replication или Veeam Agent могут хранить дополнительную резервную копию в облаке De Novo. В случае аварии данные можно восстановить как на собственной площадке, так и непосредственно в инфраструктуре оператора.
Для защиты от программ-шифровальщиков (ransomware), а также от уничтожения или повреждения самих резервных копий используется сервис Hardened Backup Repository (HBR) — защищенное масштабируемое хранилище, интегрируемое в существующую систему резервного копирования заказчика. HBR обеспечивает создание, хранение и восстановление неизменяемых (immutable) копий, а также изоляцию резервного контура от основной инфраструктуры (Air Gap), позволяя реализовать стратегию «3-2-1-1» и восстановить данные даже в тех случаях, когда основные резервные копии повреждены, скомпрометированы или физически уничтожены. Такой подход необходим, когда злоумышленники получают доступ к основной инфраструктуре и пытаются повредить не только рабочие данные, но и точки восстановления.
Отдельный уровень географической защиты обеспечивает новый сервис EU Shadow Copy, позволяющий пользователям украинского коллективного облака De Novo бесплатно создать и регулярно обновлять копию облачного ландшафта, которая будет храниться на европейской площадке De Novo EU Cloud. При необходимости копия может быть использована для восстановления клиентской инфраструктуры в Европе. Целевой RPO сервиса составляет от 24 часов, RTO — 4–5 дней, то есть он создан для некритичных систем. Если же существуют жесткие требования ко времени восстановления, то для таких случаев De Novo предлагает другие решения.
Наиболее комплексный сценарий — полное восстановление облачной инфраструктуры после аварии, в том числе при физическом уничтожении одной из площадок. Для этого используется Disaster Recovery as a Service. В De Novo предусмотрены два основных сценария: Native Cloud Disaster Recovery (NCDR) — для репликации между собственной инфраструктурой пользователя и облаком, а также Inter Cloud Disaster Recovery (ICDR) — для репликации между облаками оператора в Украине и ЕС. В зависимости от конфигурации защищенная инфраструктура может быть восстановлена с заданными параметрами RPO/RTO за время от нескольких часов до десятков минут.
Однако технические средства — лишь часть комплексного подхода. Защита реализована также на уровне управления и поддержки. В частности, группы специалистов распределены между несколькими офисами оператора — резервные площадки имеются как в Украине, так и за рубежом. Таким образом, если один из офисов будет утрачен, другие смогут полностью взять на себя функции управления.
Еще один важный момент. De Novo является участником и одним из основателей Украинского альянса цифрового суверенитета (DSUA), объединяющего ведущих операторов облаков и ЦОД в стране. Это позволяет строить сложные распределенные и надежные архитектуры защиты данных полностью на территории Украины, что особенно важно для организаций, работающих с чувствительными данными.
Фото: участники Альянса во время рабочей встречи в одном из офисов De Novo
«Критически важные данные и вычисления не должны зависеть от одного дата-центра или единственного провайдера. Инфраструктуру необходимо распределять между несколькими площадками, чтобы компания могла продолжать работу даже в случае серьезного инцидента. Именно в этом заключается зрелый подход к цифровой устойчивости. Его основа — инженерная дисциплина, архитектура резервирования и готовность платить за катастрофоустойчивость до аварии, а не после нее.
Кстати, именно такая логика заложена в подход, который продвигает DSUA — Украинский альянс цифрового суверенитета, соучредителем которого является De Novo. Речь идет о децентрализации обработки и хранения информации, о распределенной национальной облачной экосистеме и о мультидоменной системе безопасности. Это практический ответ на вызовы реального мира, в котором дата-центры могут подвергаться физическим атакам, каналы связи — нарушаться, а отдельные облачные регионы — временно становиться недоступными», — отмечает Максим Агеев.
Разные методы защиты от разных угроз
Полноценная data-centric архитектура должна одновременно охватывать несколько вероятных сценариев, среди которых — локальный отказ оборудования, полная потеря площадки, повреждение либо несанкционированное удаление или изменение данных и т. д. При этом не существует единого механизма или технологии, способных решить все эти проблемы одновременно, — необходим комплексный архитектурный подход. Особенность концепции data-centric заключается в том, что она позволяет защищаться от различных классов угроз, используя оптимальные механизмы для каждого из них.
Устойчивость данных должна проектироваться с учетом конкретных сценариев отказов. Аппаратный сбой отдельного сервера или системы хранения компенсируется, например, локальным резервированием. Но этот механизм работает лишь до тех пор, пока сохраняется сама площадка. Защита от потери целого ЦОД уже требует географического разнесения площадок, причем на такое расстояние, чтобы обе не зависели от одной энергосистемы или сети связи. В Украине предпочтительно, чтобы хотя бы одна копия данных размещалась в ЦОД за пределами страны. При этом одной географической удаленности недостаточно — необходимо заранее понимать, на какой инфраструктуре будут восстановлены виртуальные машины и приложения, откуда возьмутся их конфигурации и сетевые настройки, кто выполнит переключение и т. д.
Как подчеркивает Максим Агеев: «В украинских облачных сервисах все чаще используется распределенная модель, когда нагрузки и данные разносятся между несколькими территориально удаленными облаками, в том числе на территории ЕС. Такая архитектура снижает зависимость от одного географического региона и повышает общую устойчивость ИТ-систем. Однако главный вывод заключается в другом. Сама по себе облачная модель не гарантирует ни отказоустойчивости, ни доступности сервисов, даже если это AWS или кто-либо другой. Облако лишь меняет способ организации инфраструктуры. Оно не отменяет физику, не устраняет последствия войны и не исправляет ошибки в архитектуре».
Также критически важно различать такие понятия, как «доступность» (availability), «сохранность» (durability) и «целостность» (integrity) данных.
Например, синхронное копирование между двумя системами хранения — репликация — защищает от отказа одного массива, но не поможет, если сами данные были повреждены или скомпрометированы. Поэтому необходимы также резервные копии (backup), в том числе неизменяемые (immutable).
Репликация и backup
Эти два подхода часто смешивают, хотя они решают разные задачи.
Репликация — это постоянное или относительно частое копирование изменений между системами, а backup — сохранение независимых точек состояния данных во времени. Задача репликации — создать актуальную копию, чтобы можно было быстро продолжить работу в случае отказа основной инфраструктуры. Backup необходим для того, чтобы вернуться «назад во времени» и восстановить файл, базу данных или даже всю систему в состоянии, в котором она находилась до сбоя. То есть репликация копирует текущее состояние, а backup «консервирует» прошлое.
Immutable backup
Еще один негативный сценарий — целенаправленная кибератака, во время которой злоумышленники пытаются уничтожить или зашифровать не только основной массив данных, но и все резервные копии. Поэтому создание неизменяемого хранилища (immutable backup) сегодня является обязательным элементом для любой крупной и средней компании. Особенность immutable-копий заключается в том, что их невозможно изменить или удалить в течение установленного периода.
При этом важно понимать, что само по себе количество копий, каким бы большим оно ни было, не гарантирует защиты. Важен также архитектурный подход. Например, если несколько хранилищ управляются из одной учетной записи или через общий административный механизм, существует высокий риск получения злоумышленниками доступа ко всем резервным копиям. Поэтому наиболее критичная резервная копия должна быть отделена от основной инфраструктуры специальными правами доступа или физически. Четыре копии на одной площадке с единым управлением защищают слабее, чем две копии, размещенные в действительно независимых средах
На практике одним из наиболее распространенных подходов к хранению резервных копий является так называемое правило «3-2-1-1»: должно существовать как минимум три экземпляра данных, размещенных как минимум на двух разных типах носителей или систем хранения, причем одна копия должна находиться за пределами основной площадки, а хотя бы одна — быть офлайн, физически изолированной от основной сети (air-gapped) или неизменяемой (immutable backup). Смысл правила заключается не столько в количестве копий, сколько в устранении единой точки отказа.
Recovery Time Objective и Recovery Point Objective
Но количество и расположение копий еще не определяют, насколько быстро и с какими потерями бизнес сможет восстановиться. Для этого используют два показателя — RTO и RPO. RTO (Recovery Time Objective) показывает, как долго система может оставаться недоступной — например, час или рабочий день. RPO (Recovery Point Objective) показывает, насколько далеко назад во времени допустима потеря данных — например, за последние три часа или сутки.
Эти величины независимы. Это означает, что можно иметь реплику с данными получасовой давности, но потратить несколько часов на запуск приложений; и наоборот, резервную площадку можно запустить за час, но последняя корректная копия данных окажется недельной давности.
Disaster Recovery
Также важно понимать разницу между резервным копированием и аварийным восстановлением (Disaster Recovery, DR). Первое отвечает прежде всего за сохранность данных и возможность вернуться к корректному состоянию на определенный момент времени. DR должен обеспечивать восстановление всей информационной системы после потери основной инфраструктуры: данных, виртуальных машин, приложений, настроек, зависимостей и последовательности запуска компонентов. Поэтому полноценный DR-сценарий заранее определяет, что именно будет восстанавливаться, где, из какой копии, на каких ресурсах, с каким RPO и за какое время — RTO. Эти показатели должны подтверждаться регулярными практическими тестами, а не только расчетами.
Создание эффективной системы защиты данных в облаке, учитывающей все современные угрозы, — сложная задача. Настоящая устойчивость возникает лишь при комплексном подходе, когда данные, а не инфраструктура, становятся центром архитектуры. В этом и заключается главный принцип подхода data-centric: дата-центр может выйти из строя, оператор может вообще исчезнуть, но данные должны сохраняться и оставаться доступными пользователю при любых условиях.
$button$