


Архітектура data-centric: De Novo перебудувала логіку своєї роботи
2026-10-21

De Novo перебудувала логіку роботи. Головним об’єктом захисту є клієнтські дані, а не інфраструктура операторського ЦОД. Саме такий принцип компанія закладає в новий підхід до розбудови хмари, втілений з огляду на військові загрози.
ЦОД рівня Tier III забезпечує резервування ключових інженерних компонентів та шляхів їх розподілу, даючи змогу обслуговувати їх без зупинки ІТ-систем. Але що станеться, якщо «точкою відмови» стане увесь дата-центр? Йдеться не лише про Україну. Загроза диверсій та раптових атак вже актуальна для будь-якої країни. Гарантувати клієнтам безперервність бізнес-процесів і швидке відновлення після катастроф дає змогу архітектура data-centric,яка до того ж повністю відповідає найновішим нормативним вимогам.
У статті розглядаємо:
- у чому полягає різниця між підходами data-centric та infrastructure resilience;
- які хмарні сервіси забезпечують справжню відмовостійкість;
- як нове українське законодавство зобов’язує державний сектор змінювати підхід до захисту даних та як це перетинається з новим підходом De Novo.
Безпечних місць у світі не залишилося
Погляньмо на факти: війна в Україні триває вже багато років, але першими в історії дата-центрами, що потрапили під авіаудари, несподівано стали об’єкти гіперскейлерів у, здавалося б, благополучному регіоні. Нагадаємо, що в березні 2026 року внаслідок ударів безпілотників було серйозно пошкоджено одразу три ЦОД AWS — два в ОАЕ та один у Бахрейні. Клієнти у відповідному регіоні миттєво відчули наслідки атаки, а її наслідків не було повністю усунуто навіть через пів року: наприклад, 15 вересня повідомлялося, що оператор усе ще не зміг відновити повний доступ до пошкоджених об’єктів.
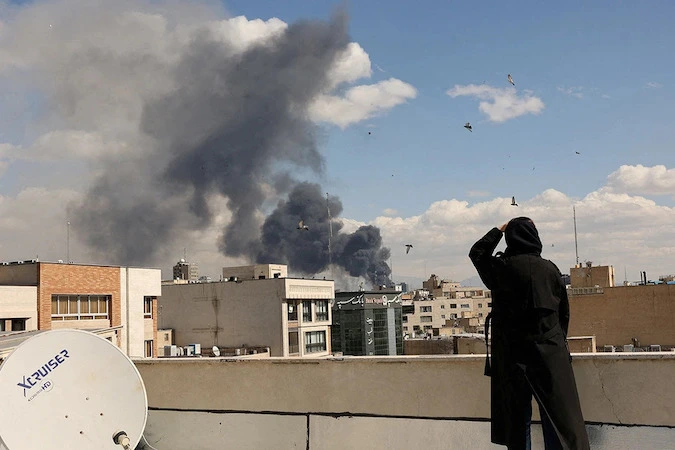
Отже, ризик, який ще донедавна сприймався як суто «український», фактично стає частиною глобального підходу до побудови цифрової інфраструктури.
«Будь-який провайдер виглядає молодцем, поки не доходить до справжнього стрес-тесту. Дата-центри AWS впали під ударами, як упав би будь-який інший дата-центр у світі. Ця ситуація підсвітила злам звичного світу. Західні мега-ЦОД на 100–200 МВт будувалися з огляду на економіку та масштабування. Ніхто ніколи не думав, що може бути війна. А тепер виявилося, що такий дата-центр можна зруйнувати одним дроном. Як ту кришталеву піраміду — вона впаде від одного дотику. Тому зараз питання має ставитися інакше: яку концепцію безпеки ви пропонуєте? Якщо ми говоримо про Data Center-centric підхід, то все залежить від фізичної будівлі. Якщо ми забираємо слово «центр» і кажемо Data-centric, то в основі стоять самі дані. Якщо у вас є розподілена архітектура і механізми швидкого відновлення, ви можете зруйнувати один чи два дата-центри, а система продовжить працювати», — зазначав в одному з інтерв’ю Максим Агєєв, CEO компанії De Novo.
Фокус зміщується з інфраструктури на дані
У таких екстремальних умовах традиційний підхід infrastructure resilience, сенс якого — не допустити відмови обладнання або майданчика, поступається місцем data resiliency, за якого головним об’єктом захисту стають дані клієнта. У ширшому сенсі такий підхід можна назвати data-centric architecture: саме дані розглядаються як центральний актив, а локальна інфраструктура, застосунки та процеси будуються навколо вимог до них.
«De Novo називає такий підхід data-centric: у центрі архітектури мають бути не сервер чи майданчик, а дані клієнта. Для цього створюють три-чотири копії даних, використовують системи резервування та географічне рознесення. Наприклад, De Novo використовує чотири майданчики — два в Україні та два в Європі. Інформаційні системи можуть бути рознесені між різними майданчиками, щоб забезпечити їх відновлення після можливої катастрофи.
Цей піlхід — альтернатива логіці постійної втечі від ризику. Частина даних уже була винесена за межі країни, але для систем, які залишаються в Україні, мають діяти нові правила стійкості — резервування, дублювання та географічне рознесення. Саме це, і є resilience — здатність системи пережити удар, не втративши головного: даних. Іншими словами — неважливо, що буде з нашим дата-центром. Важливо, що буде з вашими даними. Отже захищати потрібно дані, а не дата-центр» — розповідає Максим Агєєв.
Водночас надійність окремого ЦОД й надалі є обов’язковою, але вона не повинна бути єдиною умовою збереженості даних. На практиці найвищий рівень захисту сьогодні досягається тоді, коли дані існують у кількох незалежних формах і місцях: на різних системах зберігання, у резервних копіях, на географічно рознесених майданчиках або навіть у різних країнах і хмарах різних операторів.
Ваші дані мають пережити навіть повне фізичне знищення одного або кількох дата-центрів
Для цього сьогодні сформувалася загальноприйнята світова практика, якої дотримуються як світові лідери — гіперскейлери, так і великі національні оператори більшості розвинених країн. Її суть полягає у створенні територіально розподілених та фізично незалежних майданчиків, об’єднаних у єдину систему. За такого підходу повне знищення одного або навіть кількох фізичних ЦОД не призведе до зупинки всієї системи.
Але є один надзвичайно важливий нюанс: збереженість даних не виникає автоматично лише завдяки розміщенню в захищеній і розподіленій хмарі. Створення резервних копій (backup), катастрофостійких рішень (Disaster Recovery), управління даними та інші операції залишаються відповідальністю клієнта. Оператор надає інфраструктуру та інструменти для виконання таких завдань.
Максим Агєєв наголошує: «Жоден провайдер у світі не здатний гарантувати безперервність роботи сервісів або доступність даних, якщо сама архітектура ІТ-системи замовника не передбачає резервування та катастрофостійкості. Саме тому варто чітко усвідомлювати зону відповідальності самого бізнесу».
Держава вимагає конкретних заходів: постанова Кабінету Міністрів України № 1009
Архітектура data-centric набуває особливого значення в контексті останніх законодавчих змін в Україні. Донедавна вимоги до захисту даних у хмарах не завжди були достатньо деталізованими, а конкретика часто залишалася сферою відповідальності кожної організації. Але ситуація змінюється. Наприклад, у серпні 2026 року було ухвалено постанову Кабінету Міністрів України № 1009 «Деякі питання забезпечення безперервності функціонування державних інформаційних ресурсів», яка досить чітко описує вимоги до захищеної архітектури зберігання важливих даних. Варто зауважити, що в документі всі ключові процеси описано загальноприйнятою мовою ІТ, зі зрозумілими абревіатурами, формулюваннями та конкретними цифрами.
Додатково визначається MTPD — максимально допустимий час порушення роботи системи, після якого наслідки стають неприйнятними (при цьому MTPD має бути більшим за RTO й не може перевищувати 1,5 граничного значення RTO відповідної категорії).
Що особливо важливо — йдеться не лише про захист даних, а й про відновлення працездатності всієї ІТ-системи, включно з ПЗ, налаштуваннями, взаємозв’язками тощо. Фактично описується повноцінний DR-сценарій. Основний і резервний майданчики при цьому мають бути незалежними, щоб зменшити ризик одночасного знищення або компрометації даних. Ба більше, для систем I та II категорій прямо зазначено географічне рознесення основного й резервного дата-центрів, а якщо основна система розташована в Україні, щонайменше один примірник відновлювального резерву має розміщуватися в захищеному середовищі за кордоном. До речі, прописано й зворотне правило: якщо основна інфраструктура розташована за кордоном, один примірник резерву має перебувати в Україні.
За словами Максима Агєєва: “постанова № 1009 запроваджує найкращі світові DR-практики у сфері державного управління критичними даними та ІТ-інфраструктурами. Документ, по суті, формалізує та деталізує підходи, які на практиці підтвердили свою ефективність. Безумовно, це надзвичайно важливий крок на шляху до побудови справді захищених державних ІТ-систем, крок, який, на мою думку, варто було зробити ще років десять тому”.
Тобто простого бекапу вже недостатньо, принаймні для організацій, на які поширюється регулювання згаданої постанови (це насамперед державні структури та інформаційні ресурси). Також відповідно до нових вимог організаціям необхідно мати чіткий план аварійного відновлення та регулярно, щонайменше раз на пів року, його тестувати. Перевірка також має виконуватися після будь-яких суттєвих змін в ІТ-системі. Серед сценаріїв, що підлягають перевірці, — відновлення даних із резервної копії, перемикання (failover) окремих компонентів чи навіть всієї системи на резервний майданчик.
Архітектура data-centric у хмарі De Novo
Компанія De Novo давно й послідовно розвиває комплексну архітектуру захисту даних для різних сценаріїв. Для цього використовується набір спеціально відібраних та відпрацьованих технологій та незалежних механізмів, що формують єдиний комплекс захисту. Різні рівні захисту розв’язують різні завдання — від логічного пошкодження даних до повної втрати основного майданчика.
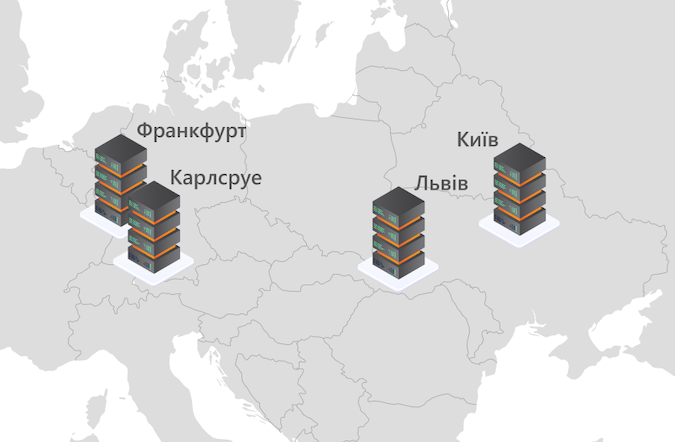
Основу стійкості інфраструктури De Novo забезпечують одразу чотири територіально розподілені дата-центри: по два в Україні (Київ, Львів) та Німеччині (Франкфурт-на-Майні, Карлсруе). Щодо механізмів відновлення, то на базовому рівні працюють сервіси BaaS та Flex Backup. Вони дають змогу створювати локальні резервні копії хмарної інфраструктури та зберігати їх окремо від основного робочого середовища користувача. Якщо потрібен захист від втрати всього майданчика, використовується так звана «геокопія»: сервіс BaaS Geo дозволяє розмістити додаткову копію даних в іншій хмарі De Novo на території Європейського Союзу (EU-Cloud), при цьому фізична відстань між хмарними майданчиками становить щонайменше 1500 км.
Ще більшу незалежність забезпечують BaaS Geo XR і Flex Backup Geo XR. Тут географічна копія зберігається вже в об’єктному сховищі AWS S3. Замовнику надаються окремі дані доступу та ключ шифрування, а відновлення можливе в середовищах VMware і Hyper-V, на платформах AWS, Microsoft Azure та GCP або назад в одну з хмар De Novo. Це вже не лише захист від втрати конкретного ЦОД, але також механізм запобігання залежності від однієї хмарної платформи.
Якщо основна інфраструктура розміщена у власному дата-центрі замовника, аналогічне завдання виконує Veeam Cloud Repository (VCR). Користувачі Veeam Backup & Replication або Veeam Agent можуть зберігати додаткову резервну копію в хмарі De Novo. У разі аварії дані можна відновити як на власному майданчику, так і безпосередньо в інфраструктурі оператора.
Для захисту від програм-шифрувальників (ransomware), а також від знищення або пошкодження самих резервних копій використовується сервіс Hardened Backup Repository (HBR) — захищене масштабоване сховище, яке інтегрується в наявну систему резервного копіювання замовника. HBR забезпечує створення, зберігання та відновлення незмінюваних (immutable) копій, а також ізоляцію резервного контуру від основної інфраструктури (Air Gap), даючи змогу реалізувати стратегію «3-2-1-1» та відновити дані навіть у тих випадках, коли основні резервні копії пошкоджені, скомпрометовані або фізично знищені. Такий підхід потрібен, коли зловмисники отримують доступ до основної інфраструктури й намагаються пошкодити не лише робочі дані, а й точки відновлення.
Окремий рівень географічного захисту забезпечує новий сервіс EU Shadow Copy, який дає змогу користувачам української колективної хмари De Novo безоплатно створити й регулярно оновлювати копію хмарного ландшафту, що буде зберігатися на європейському майданчику De Novo EU Cloud. За потреби копія може бути використана для відновлення клієнтської інфраструктури в Європі. Цільовий RPO сервісу становить від 24 годин, RTO — 4–5 днів, тобто його створено для некритичних систем. Якщо ж є жорсткі вимоги до часу відновлення, то для такого випадку De Novo пропонує інші рішення.
Найбільш комплексний сценарій — повне відновлення хмарної інфраструктури після аварії, зокрема в разі фізичного знищення одного з майданчиків. Для цього використовується Disaster Recovery as a Service. У De Novo передбачено два основні сценарії: Native Cloud Disaster Recovery (NCDR) — для реплікації між власною інфраструктурою користувача та хмарою, а також Inter Cloud Disaster Recovery (ICDR) — для реплікації між хмарами оператора в Україні та ЄС. Залежно від конфігурації захищена інфраструктура може бути відновлена з визначеними параметрами RPO/RTO за час від кількох годин до десятків хвилин.
Проте технічні засоби — це лише частина комплексного підходу. Захист реалізовано також на рівні управління та підтримки. Зокрема, групи фахівців розподілено між кількома офісами оператора — резервні майданчики є як в Україні, так і за кордоном. Таким чином, якщо один із офісів буде втрачено, інші зможуть повністю перейняти на себе функції керування.
Ще один важливий момент. De Novo є учасником й одним із засновників Українського альянсу цифрового суверенітету (DSUA), який об’єднує провідних операторів хмар та ЦОД у країні. Це дає змогу будувати складні розподілені та надійні архітектури захисту даних повністю на території України, що особливо важливо для організацій, які працюють із чутливими даними.
Фото: Учасники Альянсу під час робочої зустрічі в одному з офісів De Novo
«Критично важливі дані та обчислення не повинні залежати від одного дата-центру чи єдиного провайдера. Інфраструктуру треба розподіляти між кількома майданчиками, щоб компанія могла продовжувати роботу навіть у разі серйозного інциденту. Саме в цьому полягає зрілий підхід до цифрової стійкості. Його основа — інженерна дисципліна, архітектура резервування та готовність платити за катастрофостійкість до аварії, а не після неї.
До речі, саме така логіка закладена в підхід, який просуває DSUA — Український альянс цифрового суверенітету, співзасновником якого є De Novo. Йдеться про децентралізацію обробки та зберігання інформації, про розподілену національну хмарну екосистему й про мультидоменну систему безпеки. Це практична відповідь на виклики реального світу, у якому дата-центри можуть бути фізично атаковані, канали зв’язку — порушені, а окремі хмарні регіони — тимчасово втрачені» — зазначає Максим Агєєв.
Різні методи захисту від різних загроз
Повноцінна data-centric архітектура має одночасно охоплювати кілька ймовірних сценаріїв, серед яких — локальна відмова обладнання, повна втрата майданчика, пошкодження або несанкціоноване видалення чи зміна даних тощо. При цьому не існує єдиного механізму або технології, здатних розв’язати всі ці проблеми одразу, — потрібен комплексний архітектурний підхід. Особливість концепції data-centric полягає в тому, що вона дає змогу захищатися від різних класів загроз, використовуючи оптимальні механізми для кожного з них.
Стійкість даних має проєктуватися відповідно до конкретних сценаріїв відмов. Апаратний збій окремого сервера або системи зберігання компенсується, наприклад, локальним резервуванням. Але цей механізм працює лише доти, доки зберігається сам майданчик. Захист від втрати цілого ЦОД уже потребує географічного рознесення майданчиків, причому на таку відстань, щоб обидва не залежали від однієї енергосистеми або мережі зв’язку. В Україні краще, щоб хоча б одна копія даних розміщувалася в ЦОД за межами країни. При цьому самої географічної віддаленості недостатньо — потрібно заздалегідь розуміти, на якій інфраструктурі будуть відновлені віртуальні машини та застосунки, звідки візьмуться їхні конфігурації й мережеві налаштування, хто виконає перемикання тощо.
Як підкреслює Максим Агєєв: «В українських хмарних сервісах дедалі частіше використовується розподілена модель, коли навантаження й дані розносяться між кількома територіально віддаленими хмарами, зокрема й на території ЄС. Така архітектура зменшує залежність від одного географічного регіону та підвищує загальну стійкість ІТ-систем. Проте головний висновок полягає в іншому. Сама по собі хмарна модель не гарантує ані відмовостійкості, ані доступності сервісів, навіть якщо це AWS чи будь-хто інший. Хмара лише змінює спосіб організації інфраструктури. Вона не скасовує фізику, не прибирає наслідки війни й не виправляє помилки в архітектурі».
Також критично важливо розрізняти такі поняття, як «доступність» (availability), «збережність» (durability) та «цілісність» (integrity) даних.
Наприклад, синхронне копіювання між двома системами зберігання — реплікація — захищає від відмови одного масиву, але не допоможе, якщо самі дані були пошкоджені або скомпрометовані. Тому потрібні також резервні копії (backup), зокрема такі, що неможна змінити (immutable).
Реплікація та backup
Ці два підходи часто змішують, хоча вони вирішують різні завдання.
Реплікація — це постійне або відносно часте копіювання змін між системами, а backup — збереження незалежних точок стану даних у часі. Завдання реплікації — створити актуальну копію, щоб можна було швидко продовжити роботу в разі відмови основної інфраструктури. Backup потрібен для того, щоб повернутися «назад у часі» та відновити файл, базу даних або навіть усю систему в стані, у якому вона перебувала до збою. Тобто реплікація копіює поточний стан, а backup «консервує» минуле.
Immutable backup
Ще один негативний сценарій — цілеспрямована кібератака, під час якої зловмисники намагаються знищити або зашифрувати не лише основний масив даних, а й усі резервні копії. Тому створення незмінюваного сховища (immutable backup) сьогодні є обов’язковим елементом для будь-якої великої та середньої компанії. Особливість immutable-копій полягає в тому, що їх неможливо змінити або видалити протягом установленого періоду.
При цьому важливо розуміти, що сама лише кількість копій, якою б великою вона не була, не гарантує захисту. Важливий також архітектурний підхід. Наприклад, якщо кілька сховищ керуються з одного облікового запису або через спільний адміністративний механізм, існує високий ризик отримання зловмисниками доступу до всіх резервних копій. Тому найкритичніша резервна копія має бути відокремлена від основної інфраструктури спеціальними правами доступу або фізично. Чотири копії на одному майданчику з єдиним управлінням захищають слабше, ніж дві копії, розміщені у справді незалежних середовищах.
На практиці одним із найпоширеніших підходів до зберігання резервних копій є так зване правило «3-2-1-1»: має існувати щонайменше три примірники даних, розміщені щонайменше на двох різних типах носіїв або систем зберігання, причому одна копія має перебувати за межами основного майданчика, а хоча б одна — бути офлайн, фізично ізольованою від основної мережі (air-gapped) або незмінюваною (immutable backup). Сенс правила полягає не стільки в кількості копій, скільки в усуненні єдиної точки відмови.
Recovery Time Objective та Recovery Point Objective
Але кількість та розташування копій ще не визначають, наскільки швидко та з якими втратами бізнес зможе відновитися. Для цього використовують два показники — RTO та RPO. RTO (Recovery Time Objective) показує, як довго система може залишатися недоступною — наприклад, годину або робочий день. RPO (Recovery Point Objective) показує, наскільки далеко назад у часі допустима втрата даних — наприклад, за останні три години або добу.
Ці величини незалежні. Це означає, що можна мати репліку з даними півгодинної давності, але витратити кілька годин на запуск застосунків; і навпаки, резервний майданчик можна запустити за годину, але остання коректна копія даних виявиться тижневої давності.
Disaster Recovery
Також важливо розуміти різницю між резервним копіюванням і аварійним відновленням (Disaster Recovery, DR). Перше відповідає насамперед за збереженість даних і можливість повернутися до коректного стану на певний момент часу. DR має забезпечити відновлення всієї інформаційної системи після втрати основної інфраструктури: даних, віртуальних машин, застосунків, налаштувань, залежностей і послідовності запуску компонентів. Тому повноцінний DR-сценарій заздалегідь визначає, що саме буде відновлюватися, де, з якої копії, на яких ресурсах, з яким RPO і за який час — RTO. Ці показники мають підтверджуватися регулярними практичними тестами, а не лише розрахунками.
Створення ефективної системи захисту даних у хмарі, яка враховує всі сучасні загрози, — складне завдання. Справжня стійкість виникає лише за комплексного підходу, коли дані, а не інфраструктура, стають центром архітектури. У цьому й полягає головний принцип підходу data-centric: дата-центр може вийти з ладу, оператор може взагалі зникнути, але дані мають зберігатися й залишатися доступними для користувача за будь-яких умов.